机器学习 / A LEAF IN THE GARDEN
GRU
机器学习 · 动手深度学习。来自 Daily Learning 的学习笔记。
简介
Gated Recurrent Unit (GRU) 引入门控机制改进 RNN。
不是每个观察值都同等重要,只想记住关键信息
- 能关注重点的机制(更新门)
- 能遗忘的机制(重置门)
门
输出 之间的值,控制信息的流动
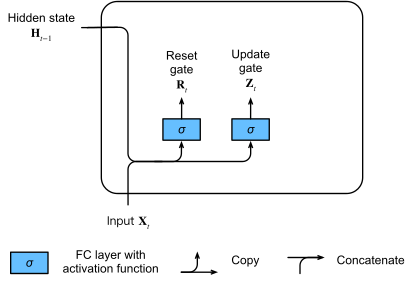
其中 是 Sigmoid 函数,输出在 之间。
候选隐藏状态
部分遗忘上一时刻的隐藏状态,结合当前时刻的输入,得到候选隐藏状态
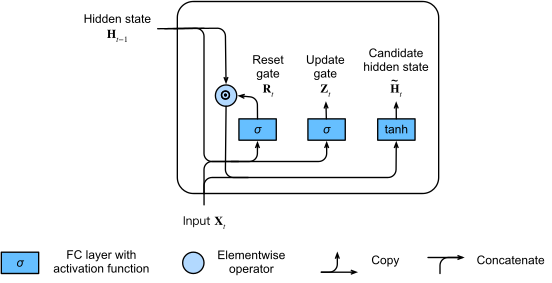
与 RNN 相比, 变成了
- 表示逐元素相乘
- 中元素范围是
所以 可以选择性地遗忘上一时刻的隐藏状态
- 全 0,则 ,完全遗忘上一时刻的隐藏状态
- 全 1,则 ,完全记住,与 RNN 相同
- 中元素在 0 和 1 之间,则 部分遗忘上一时刻的隐藏状态
隐藏状态
在旧状态和新候选状态中进行平衡。
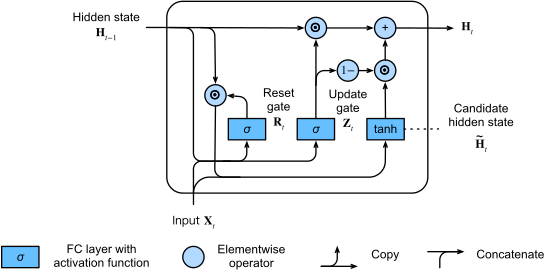
- 中元素范围是
- 中元素范围是
所以 可以选择性地记住上一时刻的隐藏状态, 可以选择性地记住候选隐藏状态
- 全 0,则 ,只记住候选隐藏状态
- 全 1,则 ,只记住上一时刻的隐藏状态,与 RNN 相同
- 中元素在 0 和 1 之间,则 融合上一时刻的隐藏状态和候选隐藏状态
从零实现
代码 4 · In [7]
import torch
from torch import nn
import util
代码 5 · In [8]
batch_size = 32
num_steps = 35
train_iter, vocab = util.data.load_data_time_machine(batch_size, num_steps)
初始化参数
代码 7 · In [9]
def get_params(vocab_size, num_hiddens, device):
    num_inputs = num_outputs = vocab_size # 输出层的维度和词表大小相同
    def normal(shape):
        return torch.randn(size=shape, device=device) * 0.01
    def three():
        """两个 W 和一个 b"""
        return (normal((num_inputs, num_hiddens)), # Wx
                normal((num_hiddens, num_hiddens)), # Wh
                torch.zeros(num_hiddens, device=device)) # b
    W_xz, W_hz, b_z = three()  # 更新门参数
    W_xr, W_hr, b_r = three()  # 重置门参数
    W_xh, W_hh, b_h = three()  # 候选隐藏状态参数
    # 输出层参数
    W_hq = normal((num_hiddens, num_outputs))
    b_q = torch.zeros(num_outputs, device=device)
    # 附上梯度
    params = [W_xz, W_hz, b_z, W_xr, W_hr, b_r,
              W_xh, W_hh, b_h, W_hq, b_q]
    for param in params:
        param.requires_grad_(True)
    return params
初始化隐藏状态
代码 9 · In [10]
def init_gru_state(batch_size, num_hiddens, device):
    return (torch.zeros((batch_size, num_hiddens), device=device), )
定义 GRU 前向计算
代码 11 · In [11]
def gru(inputs, state, params):
    # 参数
    (W_xz, W_hz, b_z,
     W_xr, W_hr, b_r,
     W_xh, W_hh, b_h,
     W_hq, b_q) = params
    # 状态
    H, = state
    outputs = []
    for X in inputs:
        # 门控
        Z = torch.sigmoid(X @ W_xz + H @ W_hz + b_z) # 更新门
        R = torch.sigmoid(X @ W_xr + H @ W_hr + b_r) # 重置门
        # 候选隐藏状态
        H_tilda = torch.tanh(X @ W_xh + (R * H) @ W_hh + b_h)
        # 隐藏状态
        H = Z * H + (1 - Z) * H_tilda
        # 输出层
        Y = H @ W_hq + b_q
        outputs.append(Y)
    return torch.cat(outputs, dim=0), (H,)
训练
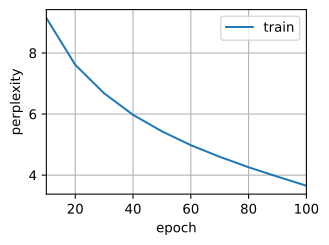
代码 13 · In [12]
vocab_size = len(vocab)
num_hiddens = 256
device = util.try_gpu()
num_epochs = 100
lr = 1
model = util.model.RNNModelScratch(len(vocab), num_hiddens, device, get_params, init_gru_state, gru)
util.train.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
已保存输出
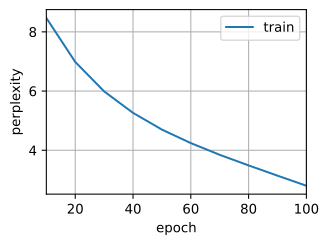
困惑度 3.7, 49293.2 token/秒
预测: time traveller stood and the stars and strange and the spoke of t
预测: traveller and the strange grous of the sun stead of the sun
简洁实现
代码 15 · In [13]
gru_layer = nn.GRU(input_size=vocab_size, hidden_size=num_hiddens)
model = util.model.RNNModel(gru_layer, vocab_size).to(device)
util.train.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
已保存输出
困惑度 2.8, 631095.9 token/秒
预测: time traveller starping that i should have sat down the same stan
预测: traveller storping of the stars to rest the thing was and sh