机器学习 / A LEAF IN THE GARDEN
感知机
机器学习 · 动手深度学习。来自 Daily Learning 的学习笔记。
感知机
给定输入 ,权重 和偏移量 ,感知机的输出为
多层感知机
- 输入
- 隐藏层
- 输出层
- 输出
MLP 从零实现
代码 3 · In [1]
import torch
from torch import nn
单隐藏层,256 个隐藏单元,10 个输出单元
代码 5 · In [2]
class MLP:
    def __init__(self, num_inputs, num_hiddens, num_outputs):
        self.num_inputs = num_inputs
        self.num_hiddens = num_hiddens
        self.num_outputs = num_outputs
        self.loss = nn.CrossEntropyLoss() # 损失函数
        self.w1 = nn.Parameter(torch.randn(self.num_inputs, self.num_hiddens, requires_grad=True))
        self.b1 = nn.Parameter(torch.zeros(self.num_hiddens, requires_grad=True))
        self.w2 = nn.Parameter(torch.randn(self.num_hiddens, self.num_outputs, requires_grad=True))
        self.b2 = nn.Parameter(torch.zeros(self.num_outputs, requires_grad=True))
        self.params = [self.w1, self.b1, self.w2, self.b2]
        self.updater = torch.optim.SGD(self.params, lr=0.1) # 优化器

    @staticmethod
    def relu(x):
        """ReLU 激活函数"""
        # zeros_like 返回一个与 x 形状和类型相同的全零张量
        return torch.max(x, torch.zeros_like(x))

    def forward(self, x):
        """前向传播"""
        x = x.reshape((-1, self.num_inputs)) # 展平
        h = self.relu(x @ self.w1 + self.b1) # 隐藏层
        return h @ self.w2 + self.b2 # 输出层

    def train_ch3(self, train_iter, test_iter, num_epochs):
        """训练模型"""
        from util import train_ch3
        train_ch3(self, train_iter, test_iter, self.loss, num_epochs, self.updater)
加载数据
代码 7 · In [3]
from util import load_data_fashion_mnist
batch_size = 256
train_iter, test_iter = load_data_fashion_mnist(batch_size)
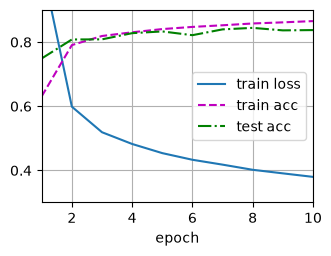
训练 10 个 epoch
代码 9 · In [16]
num_epochs = 10
model = MLP(num_inputs=784, num_hiddens=256, num_outputs=10)
model.train_ch3(train_iter, test_iter, num_epochs)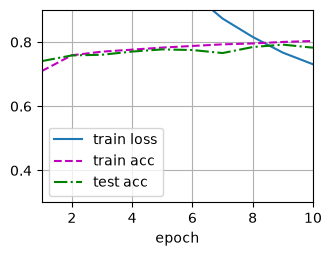
MLP 简洁实现
代码 11 · In [17]
mlp = nn.Sequential(
    nn.Flatten(), # 展平
    nn.Linear(784, 256), # 全连接层
    nn.ReLU(), # ReLU 激活函数
    nn.Linear(256, 10) # 全连接层
)
loss = nn.CrossEntropyLoss() # 损失函数
trainer = torch.optim.SGD(mlp.parameters(), lr=0.1) # 优化器

# 初始化
def init_weights(m):
    if type(m) == nn.Linear:
        nn.init.normal_(m.weight, std=0.01)
mlp.apply(init_weights)
已保存输出
Sequential(
  (0): Flatten(start_dim=1, end_dim=-1)
  (1): Linear(in_features=784, out_features=256, bias=True)
  (2): ReLU()
  (3): Linear(in_features=256, out_features=10, bias=True)
)
代码 12 · In [18]
from util import train_ch3
train_iter, test_iter = load_data_fashion_mnist(batch_size)
train_ch3(mlp, train_iter, test_iter, loss, num_epochs, trainer)