机器学习 / A LEAF IN THE GARDEN

一些技巧

机器学习 · 动手深度学习。来自 Daily Learning 的学习笔记。

数据

数据复杂度

  • 样本个数
  • 特征维度
  • 时间、空间结构
  • 多样性
  • 噪声水平

数据划分

  • 训练集: 用于训练模型
  • 验证集: 用于模型选择、调参和早停
  • 测试集: 用于评估模型的泛化能力

K-折交叉验证

将训练集划分为 K 个子集

  • for i = 1, 2, …, K:
    • 将第 i 个子集作为验证集,其余 K-1 个子集作为训练集
    • 训练模型并评估性能

常用 k = 5 或 10

拟合效果

数据与模型

简单数据复杂数据
简单模型正常欠拟合
复杂模型过拟合正常

VC 维数

对于一个分类模型,其 VC 维数等于一个最大数据集的大小,使得该数据集可以被模型完全拟合。

评估指标

  • 训练误差: 模型在训练集上的误差
  • 泛化误差: 模型在训练集以外数据上的误差

良好的模型应当满足

  • 泛化误差低
  • 训练误差与泛化误差相差不大

权重衰退

概念

在损失函数中加入L2范数惩罚项,在训练过程中让模型偏好较小的权重值。抑制模型过拟合、提高泛化能力

L2范数惩罚项

也称均方范数

Ω(θ)=12∑i=1nθi2\Omega(\theta) = \frac{1}{2} \sum_{i=1}^{n} \theta_i^2

记为 Ω(θ)=12∣∣θ∣∣22\Omega(\theta) = \frac{1}{2} ||\theta||_2^2

损失函数

l(w)=l0(w)+η2∣∣w∣∣22l(w) = l_0(w) + \frac{\eta}{2} ||w||_2^2

其中 η\eta 为正则化系数,控制惩罚项的权重

计算梯度

δl(w)δw=δl0(w)δw+η2δ∣∣w∣∣22δw=δl0(w)δw+ηw\begin{aligned} \frac{\delta l(w)}{\delta w} &= \frac{\delta l_0(w)}{\delta w} + \frac{\eta}{2} \frac{\delta ||w||_2^2}{\delta w} \\ &= \frac{\delta l_0(w)}{\delta w} + \eta w \end{aligned}

梯度下降更新后的参数

wt+1=wt−α(δl(w)δw)=wt−α(δl0(w)δw+ηw)=(1−αη)wt−αδl0(w)δw\begin{aligned} w_{t+1} &= w_t - \alpha(\frac{\delta l(w)}{\delta w}) \\ &= w_t - \alpha(\frac{\delta l_0(w)}{\delta w} + \eta w) \\ &= (1 - \alpha \eta) w_t - \alpha \frac{\delta l_0(w)}{\delta w} \end{aligned}

其中通常 αη<1\alpha \eta < 1,因此 (1−αη)<1(1 - \alpha \eta) < 1,即每次迭代后权重都会衰减。

几何理解

在两个曲面(损失函数曲面、惩罚项曲面)的合成曲面上梯度下降,最终找到损失和惩罚项的平衡点
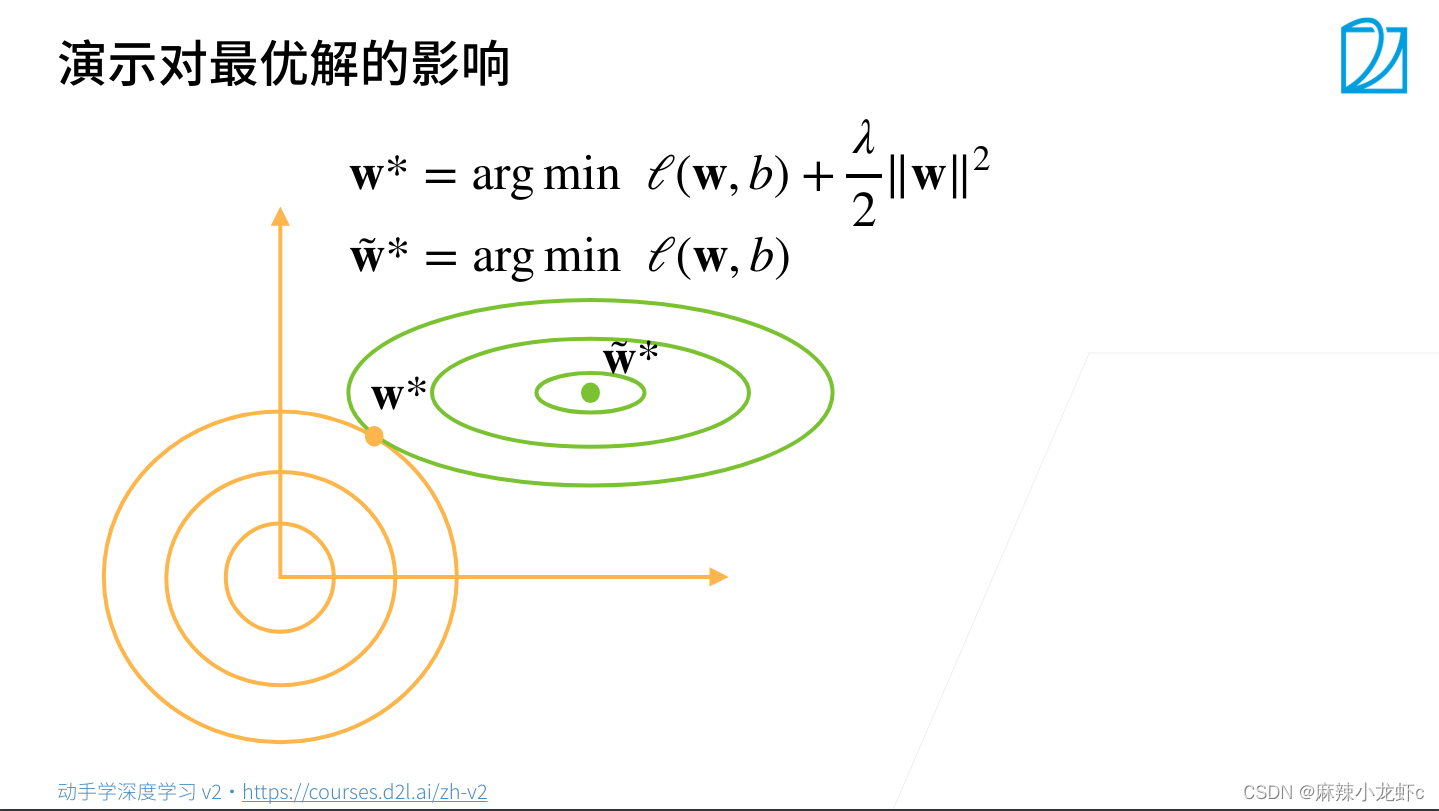
两个曲面等高线

丢弃法

概念

在训练过程中随机丢弃一部分神经元,使得模型不依赖于某些特定的神经元,从而提高模型的泛化能力。

丢弃

对每个元素进行如下扰动

xi′={0,以概率 pxi1−p,以概率 1−px_i' = \begin{cases} 0, & \text{以概率 } p \\ \cfrac{x_i}{1-p}, & \text{以概率 } 1-p \end{cases}

[!NOTE] 让一部分权重退出,另一部分权重放大,训练“子神经网络”,避免模型依赖某一两个突出神经元。

不改变期望

E[xi′]=p⋅0+(1−p)⋅xi1−p=xiE[x_i'] = p \cdot 0 + (1-p) \cdot \cfrac{x_i}{1-p} = x_i

数值稳定性

梯度问题

损失 ll 对权重 WtW^t 的梯度为 δlδWt=δlδhd⋅δhdδhd−1⋯δht+1δht⋅δhtδWt\cfrac{\delta l}{\delta W^t} = \cfrac{\delta l}{\delta h^d} \cdot \cfrac{\delta h^d}{\delta h^{d-1}} \cdots \cfrac{\delta h^{t+1}}{\delta h^t} \cdot \cfrac{\delta h^{t}}{\delta W^t}

hih_i 为向量,故 δhi+1δhi\cfrac{\delta h^{i+1}}{\delta h^i} 为矩阵,则计算梯度时做了 d−td-t 次矩阵乘法

  • 梯度爆炸: 1.5100≈4.0×10171.5^{100} \approx 4.0 \times 10^{17},梯度过大,权重更新过大,模型不收敛
  • 梯度消失: 0.5100≈7.9×10−310.5^{100} \approx 7.9 \times 10^{-31},梯度过小,权重更新过小,模型无法学习

MLP 为例

省略偏置,每一层与上一层的关系为 ht=σ(Wtht−1)h^t = \sigma(W^t h^{t-1})

计算对上一层的梯度 δhtδht−1=δσ(Wtht−1)δht−1=diag(σ′(Wtht−1))⋅(Wt)T\cfrac{\delta h^t}{\delta h^{t-1}} = \cfrac{\delta \sigma(W^t h^{t-1})}{\delta h^{t-1}} = diag(\sigma'(W^t h^{t-1})) \cdot (W^t)^T

  • diagdiag: σ\sigma 激活函数按元素,求导是对角阵(跨元素偏导为 0)
  • (Wt)T(W^t)^T: Wtht−1W^t h^{t-1} 对 ht−1h^{t-1} 逐项偏导的结果

梯度逐层累乘 gradt=∏i=t+1dδhiδhi−1=∏i=t+1ddiag(σ′(Wihi−1))⋅(Wi)Tgrad^t = \prod_{i=t+1}^{d} \cfrac{\delta h^i}{\delta h^{i-1}} = \prod_{i=t+1}^{d} diag(\sigma'(W^i h^{i-1})) \cdot (W^i)^T

ReLU 激活

σ(x)=max⁡(x,0)\sigma(x) = \max(x, 0)

{1,x>00,x≤0\begin{cases} 1, & x > 0 \\ 0, & x \leq 0 \end{cases}

diag(σ′(Wihi−1))diag(\sigma'(W^i h^{i-1})) 是只含 0、1 的对角阵

  • ⇒\Rightarrow 左乘 diag(σ′(Wihi−1))diag(\sigma'(W^i h^{i-1})) 的含义是“屏蔽某些列,保留另一些列”

  • ⇒\Rightarrow gradtgrad^t 值主要来自 ∏i=t+1d(Wi)T\prod_{i=t+1}^{d} (W^i)^T

若 d−td-t 很大,且 WiW^i 的元素 >1\gt 1,则 gradtgrad^t 很大,梯度爆炸

Sigmoid 激活

σ(x)=11+e−x\sigma(x) = \cfrac{1}{1 + e^{-x}} σ′(x)=σ(x)(1−σ(x))\sigma'(x) = \sigma(x)(1 - \sigma(x))

xx 较大或较小时,都会导致 σ′(x)\sigma'(x) 接近 0

  • ⇒\Rightarrow diag(σ′(Wihi−1))diag(\sigma'(W^i h^{i-1})) 对角线上多数元素很小

  • ⇒\Rightarrow gradtgrad^t 是接近 d−td-t 个小元素的乘积

若 d−td-t 很大,则 gradtgrad^t 很小,梯度消失

权重初始化

让初始权重的数值在一个合理范围中

  • 将每层的输入、输出和梯度看作随机变量
  • 让它们的均值、方差保持一致

MLP 为例

做如下假设

  • wi,jtw^t_{i,j} 是独立同分布,则 E[wi,jt]=0\mathbb{E}[w^t_{i,j}] = 0,D[wi,jt]=γt(常数)\mathbb{D}[w^t_{i,j}] = \gamma_t\text{(常数)}
  • hit−1h^{t-1}_i 独立于 wi,jtw^t_{i,j}
  • 暂不考虑激活函数,ht=Wtht−1h^t = W^t h^{t-1},则
E[hit]=E[∑j=1nt−1wi,jthjt−1]=∑j=1nt−1E[wi,jt]E[hjt−1]=0\mathbb{E}[h^t_i] = \mathbb{E} \left[\sum_{j=1}^{n_{t-1}} w^t_{i,j} h^{t-1}_j \right] = \sum_{j=1}^{n_{t-1}} \mathbb{E}[w^t_{i,j}] \mathbb{E}[h^{t-1}_j] = 0

正向方差

D[hit]=E[(hit)2]−(E[hit])2=E[(∑j=1nt−1wi,jthjt−1)2]=E[∑j=1nt−1(wi,jt)2(hjt−1)2+∑j1≠j2wi,j1thj1t−1wi,j2thj2t−1]=∑j=1nt−1E[(wi,jt)2]E[(hjt−1)2]=∑j=1nt−1D[wi,jt]D[hjt−1]=nt−1γtD[hjt−1]\begin{aligned} \mathbb{D}[h^t_i] &= \mathbb{E}[(h^t_i)^2] - (\mathbb{E}[h^t_i])^2 \\ &= \mathbb{E}\left[(\sum_{j=1}^{n_{t-1}} w^t_{i,j} h^{t-1}_j)^2\right] \\ &= \mathbb{E}\left[\sum_{j=1}^{n_{t-1}} (w^t_{i,j})^2 (h^{t-1}_j)^2 + \sum_{j_1 \neq j_2} w^t_{i,j_1} h^{t-1}_{j_1} w^t_{i,j_2} h^{t-1}_{j_2}\right] \\ &= \sum_{j=1}^{n_{t-1}} \mathbb{E}[(w^t_{i,j})^2] \mathbb{E}[(h^{t-1}_j)^2] \\ &= \sum_{j=1}^{n_{t-1}} \mathbb{D}[w^t_{i,j}] \mathbb{D}[h^{t-1}_j] &= n_{t-1} \gamma_t \mathbb{D}[h^{t-1}_j] \end{aligned}
  • 希望输入输出方差相等,则 nt−1γt=1n_{t-1} \gamma_t = 1

  • 反向方差同理推导出 ntγt=1n_{t} \gamma_t = 1

二者不能同时满足,Xavier 初始化取平均值,使 γt=2nt−1+nt\gamma_t = \cfrac{2}{n_{t-1} + n_t}

  • 正态分布 N(0,γt)=N(0,2nt−1+nt)\mathcal{N}(0, \sqrt{\gamma_t}) = \mathcal{N}\left(0, \sqrt{\cfrac{2}{n_{t-1} + n_t}}\right)
  • 均匀分布 U(−3γt,3γt)=U(−6nt−1+nt,6nt−1+nt)\mathcal{U}(-\sqrt{3\gamma_t}, \sqrt{3\gamma_t}) = \mathcal{U}\left(-\sqrt{\cfrac{6}{n_{t-1} + n_t}}, \sqrt{\cfrac{6}{n_{t-1} + n_t}}\right)

激活函数

稳定性条件

假设线性的激活函数 σ(x)=αx+β\sigma(x) = \alpha x + \beta,

并且有 h′=Wtht−1,ht=σ(h′)h' = W^t h^{t-1}, h^t = \sigma(h'),则

E[hit]=αE[hi′]+β=β\mathbb{E}[h^t_i] = \alpha \mathbb{E}[h'_i] + \beta = \beta D[hit]=E[(hit)2]−(E[hit])2=E[(αhi′+β)2]−β2=α2E[(hi′)2]+2αβE[hi′]+β2−β2=α2D[hi′]\begin{aligned} \mathbb{D}[h^t_i] &= \mathbb{E}[(h^t_i)^2] - (\mathbb{E}[h^t_i])^2 \\ &= \mathbb{E}[(\alpha h'_i + \beta)^2] - \beta^2 \\ &= \alpha^2 \mathbb{E}[(h'_i)^2] + 2\alpha\beta \mathbb{E}[h'_i] + \beta^2 - \beta^2 &= \alpha^2 \mathbb{D}[h'_i] \end{aligned}

希望激活前后均值为0、方差相等,需要 β=0,α=1\beta = 0, \alpha = 1,即 σ(x)=x\sigma(x) = x。

非线性激活函数

常用的激活函数泰勒展开

relu(x)=0+x,for x≥0tanh(x)=0+x−x33+O(x5)sigmoid(x)=12+x4−x348+O(x5)\begin{aligned} &relu(x) = 0 + x, for \space x \geq 0 \\ &tanh(x) = 0 + x - \frac{x^3}{3} + \mathcal{O}(x^5) \\ &sigmoid(x) = \frac{1}{2} + \frac{x}{4} - \frac{x^3}{48} + \mathcal{O}(x^5) \end{aligned}
  • relurelu 和 tanhtanh 在原点附近近似 σ(x)=x\sigma(x) = x,满足稳定性条件

  • sigmoidsigmoid 在原点附近近似 σ(x)=12+x4\sigma(x) = \frac{1}{2} + \frac{x}{4},需要调整为 4×sigmoid(x)−24\times sigmoid(x) - 2 才能满足稳定性条件