Kaggle房价预测
机器学习 · 动手深度学习。来自 Daily Learning 的学习笔记。
%matplotlib inline
import numpy as np
import pandas as pd
from torch import nn
import torch
import util
from util import DATA_HUB, DATA_URL, download
读入并处理数据
DATA_HUB['kaggle_house_train'] = (
    DATA_URL + 'kaggle_house_pred_train.csv',
    '585e9cc93e70b39160e7921475f9bcd7d31219ce')
DATA_HUB['kaggle_house_test'] = (
    DATA_URL + 'kaggle_house_pred_test.csv',
    'fa19780a7b011d9b009e8bff8e99922aa8ee2eb90')

train_data = pd.read_csv(download('kaggle_house_train'))
test_data = pd.read_csv(download('kaggle_house_test'))

print(train_data.shape)
print(test_data.shape)
已保存输出
正在从https://d2l-data.s3-accelerate.amazonaws.com/kaggle_house_pred_test.csv下载./data/kaggle_house_pred_test.csv...
(1460, 81)
(1459, 80)
简单检查数据
# 前 4 行的前 4 列和最后 3 列
print(train_data.iloc[0:4, [0, 1, 2, 3, -3, -2, -1]])
print(test_data.iloc[0:4, [0, 1, 2, 3, -3, -2, -1]])
已保存输出
   Id  MSSubClass MSZoning  LotFrontage SaleType SaleCondition  SalePrice
0   1          60       RL         65.0       WD        Normal     208500
1   2          20       RL         80.0       WD        Normal     181500
2   3          60       RL         68.0       WD        Normal     223500
3   4          70       RL         60.0       WD       Abnorml     140000
     Id  MSSubClass MSZoning  LotFrontage  YrSold SaleType SaleCondition
0  1461          20       RH         80.0    2010       WD        Normal
1  1462          20       RL         81.0    2010       WD        Normal
2  1463          60       RL         74.0    2010       WD        Normal
3  1464          60       RL         78.0    2010       WD        Normal
id 不应该拟合,删除
# iloc[:, 1:-1] 取所有行,[1, -1)列,即去掉第一列和最后一列(id、价格label)
# iloc[:, 1:] 取所有行,[1, 结束)列,即去掉第一列(id)
all_features = pd.concat((train_data.iloc[:, 1:-1], test_data.iloc[:, 1:]))
将缺失值替换为平均,特征重新缩放到 0 均值和单位方差
numeric_features = all_features.dtypes[all_features.dtypes != 'str'].index
# 标准化
all_features[numeric_features] = all_features[numeric_features].apply(lambda x: (x - x.mean()) / (x.std()))
# 将缺失值替换为 0(均值)
all_features[numeric_features] = all_features[numeric_features].fillna(0)
离散值用 one-hot 编码
# dummy_na=True 将缺失值也作为一个特征
all_features = pd.get_dummies(all_features, dummy_na=True, dtype=int)
all_features.shape # 特征变多了一些
已保存输出
(2919, 330)
从 pandas 的 dataframe 中提取 NumPy 数组,并转为 tensor
n_train = train_data.shape[0]
train_features = torch.tensor(all_features[:n_train].values, dtype=torch.float32)
test_features = torch.tensor(all_features[n_train:].values, dtype=torch.float32)
train_labels = torch.tensor(train_data.SalePrice.values, dtype=torch.float32).view(-1, 1) # view(-1, 1) 转为列向量
模型,几种对比
loss = nn.MSELoss() # 均方误差
in_features = train_features.shape[1] # 特征数

def get_net(**kwargs):
    """
    获取模型
    :param kind: 模型类型,'linear' 或 'mlp'
    :param layers: 隐藏层神经元数列表,默认 [256]
    :return: 模型
    """
    kind = kwargs.get('kind', 'linear') # 默认线性回归
    layers = kwargs.get('layers', [256]) # 默认双层mlp,隐藏层 256 个神经元
    net = None
    # 线性回归
    if kind == 'linear':
        net = nn.Linear(in_features, 1)
    # 多层感知机
    elif kind == 'mlp':
        dims = [in_features] + layers + [1]
        net = nn.Sequential()
        for i in range(len(dims) - 1):
            net.add_module(f'linear_{i}', nn.Linear(dims[i], dims[i+1]))
            if i < len(dims) - 2:
                net.add_module(f'relu_{i}', nn.ReLU())
        def init_weights(m):
            if type(m) == nn.Linear:
                # xavier 初始化,均值为 0,方差为 2/(n_in+n_out)
                nn.init.normal_(m.weight, std=np.sqrt(2 / (m.in_features + m.out_features)))
        net.apply(init_weights)
    return net
这个场景更关心相对误差 ,不被价格尺度影响,所以用对数差异
def log_rmse(net, features, labels):
    clipped_preds = torch.clamp(net(features), 1, float('inf')) # 将预测值限制在 [1, +∞) 区间,避免取对数时出现负数
    rmse = torch.sqrt(loss(torch.log(clipped_preds), torch.log(labels)))
    return rmse.item()
用 adam 优化器训练
def train(net,
          train_features, train_labels,
          test_features, test_labels,
          num_epochs, batch_size,
          learning_rate: float = 0.01,
          weight_decay: float | int = 0):
    # 记录训练集和测试集的误差
    train_ls, test_ls = [], []
    # 训练集迭代器和优化器
    train_iter = util.load_array((train_features, train_labels), batch_size)
    optimizer = torch.optim.Adam(net.parameters(), lr=learning_rate, weight_decay=weight_decay)
    for epoch in range(num_epochs):
        for X, y in train_iter:
            optimizer.zero_grad()
            # 这里用 MSELoss 计算损失,log_rmse 只在记录误差时使用
            l = loss(net(X), y)
            l.backward()
            optimizer.step()
        train_ls.append(log_rmse(net, train_features, train_labels))
        if test_labels is not None:
            test_ls.append(log_rmse(net, test_features, test_labels))
    return train_ls, test_ls
k-fold 交叉验证,k=5
def get_k_fold_data(k, i, X, y):
    assert k > 1
    fold_size = X.shape[0] // k # 每折的大小
    X_train, y_train = None, None
    for j in range(k):
        idx = slice(j * fold_size, (j + 1) * fold_size) # slice(start, stop)
        X_part, y_part = X[idx, :], y[idx]
        if j == i: # 第 i 折作为验证集
            X_valid, y_valid = X_part, y_part
        elif X_train is None: # 其他折作为训练集,第一次创建
            X_train, y_train = X_part, y_part
        else: # 其他折作为训练集,后续拼接
            X_train = torch.cat((X_train, X_part), dim=0)
            y_train = torch.cat((y_train, y_part), dim=0)
    return X_train, y_train, X_valid, y_valid

def k_fold(k,
           X_train, y_train,
           num_epochs, batch_size,
           learning_rate, weight_decay,
           **kwargs):
    train_l_sum, valid_l_sum = 0, 0 # 记录训练集和验证集的误差
    for i in range(k):
        # 创建数据和模型
        data = get_k_fold_data(k, i, X_train, y_train)
        net = get_net(**kwargs)
        # 训练并记录误差
        train_ls, valid_ls = train(net, *data, num_epochs, batch_size, learning_rate, weight_decay)
        train_l_sum += train_ls[-1] # 记录最后一个 epoch 的误差
        valid_l_sum += valid_ls[-1]
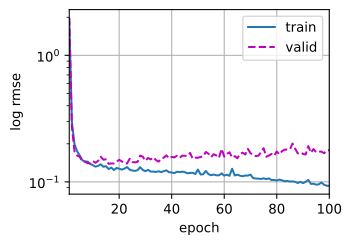
        # 绘制第一个折的训练和验证误差曲线
        if i == 0:
            util.plot(list(range(1, num_epochs + 1)), [train_ls, valid_ls],
                      xlabel='epoch', ylabel='log rmse', xlim=[1, num_epochs],
                      legend=['train', 'valid'], yscale='log')
        # 打印每折的误差
        print(f'fold {i + 1}, train log rmse {float(train_ls[-1]):f}, '
              f'valid log rmse {float(valid_ls[-1]):f}')
    # 返回平均误差
    return train_l_sum / k, valid_l_sum / k
在这里可以调参了
supparams = {
    'lr': [5, 0.1, 0.01],
    'weight_decay': [0, 0.1, 1],
    'kind': ['linear', 'mlp'],
    'layers': [[32], [128], [64, 256]]
}
k = 5
num_epochs = 100
batch_size = 32

records = pd.DataFrame(columns=['lr', 'weight_decay', 'kind', 'layers', 'train_log_rmse', 'valid_log_rmse'])

def train_attempt(lr, weight_decay, kind, layers=None):
    print(f'lr={lr}, weight_decay={weight_decay}, kind={kind}, layers={layers}')
    train_l, valid_l = k_fold(k, train_features, train_labels, num_epochs, batch_size, lr, weight_decay, kind=kind, layers=layers)
    print(f'{k}-折验证: 平均训练 log rmse {float(train_l):f}, 平均验证 log rmse {float(valid_l):f}\n')
    records.loc[len(records)] = [lr, weight_decay, kind, layers, train_l, valid_l]

for lr in supparams['lr']:
    for weight_decay in supparams['weight_decay']:
        for kind in supparams['kind']:
            if kind == 'linear':
                train_attempt(lr, weight_decay, kind)
            else:
                for layers in supparams['layers']:
                    train_attempt(lr, weight_decay, kind, layers)
records
已保存输出
lr=5, weight_decay=0, kind=linear, layers=None fold 1, train log rmse 0.149286, valid log rmse 0.146445 fold 2, train log rmse 0.145074, valid log rmse 0.162593 fold 3, train log rmse 0.143200, valid log rmse 0.149994 fold 4, train log rmse 0.148574, valid log rmse 0.145895 fold 5, train log rmse 0.143023, valid log rmse 0.173001 5-折验证: 平均训练 log rmse 0.145831, 平均验证 log rmse 0.155586lr=5, weight_decay=0, kind=mlp, layers=[32] fold 1, train log rmse 0.064428, valid log rmse 0.173620 fold 2, train log rmse 0.054594, valid log rmse 0.208562 fold 3, train log rmse 0.049757, valid log rmse 0.164170 fold 4, train log rmse 0.067940, valid log rmse 0.144012 fold 5, train log rmse 0.092283, valid log rmse 0.177836 5-折验证: 平均训练 log rmse 0.065800, 平均验证 log rmse 0.173640
lr=5, weight_decay=0, kind=mlp, layers=[128] fold 1, train log rmse 0.052929, valid log rmse 0.154730 fold 2, train log rmse 0.075253, valid log rmse 0.154349 fold 3, train log rmse 0.063599, valid log rmse 0.169575 fold 4, train log rmse 0.074558, valid log rmse 0.145228 fold 5, train log rmse 0.062261, valid log rmse 0.156504 5-折验证: 平均训练 log rmse 0.065720, 平均验证 log rmse 0.156077
lr=5, weight_decay=0, kind=mlp, layers=[64, 256] fold 1, train log rmse 3.312348, valid log rmse 3.334828 fold 2, train log rmse 2.854065, valid log rmse 2.942183 fold 3, train log rmse 0.447974, valid log rmse 0.758033 fold 4, train log rmse 0.458640, valid log rmse 0.296846 fold 5, train log rmse 0.621074, valid log rmse 0.905232 5-折验证: 平均训练 log rmse 1.538820, 平均验证 log rmse 1.647424
lr=5, weight_decay=0.1, kind=linear, layers=None fold 1, train log rmse 0.161884, valid log rmse 0.150446 fold 2, train log rmse 0.151459, valid log rmse 0.212345 fold 3, train log rmse 0.152339, valid log rmse 0.159296 fold 4, train log rmse 0.157870, valid log rmse 0.148601 fold 5, train log rmse 0.156729, valid log rmse 0.175816 5-折验证: 平均训练 log rmse 0.156056, 平均验证 log rmse 0.169301
lr=5, weight_decay=0.1, kind=mlp, layers=[32] fold 1, train log rmse 0.086492, valid log rmse 0.138218 fold 2, train log rmse 0.062240, valid log rmse 0.157519 fold 3, train log rmse 0.075397, valid log rmse 0.157249 fold 4, train log rmse 0.048399, valid log rmse 0.139307 fold 5, train log rmse 0.050575, valid log rmse 0.173632 5-折验证: 平均训练 log rmse 0.064620, 平均验证 log rmse 0.153185
lr=5, weight_decay=0.1, kind=mlp, layers=[128] fold 1, train log rmse 0.125832, valid log rmse 0.168049 fold 2, train log rmse 0.081680, valid log rmse 0.645784 fold 3, train log rmse 0.129998, valid log rmse 0.278130 fold 4, train log rmse 0.125424, valid log rmse 0.154115 fold 5, train log rmse 0.081061, valid log rmse 0.156528 5-折验证: 平均训练 log rmse 0.108799, 平均验证 log rmse 0.280521
lr=5, weight_decay=0.1, kind=mlp, layers=[64, 256] fold 1, train log rmse 0.970223, valid log rmse 1.370137 fold 2, train log rmse 3.352124, valid log rmse 3.384500 fold 3, train log rmse 0.399759, valid log rmse 0.888207 fold 4, train log rmse 0.421063, valid log rmse 0.414698 fold 5, train log rmse 2.974148, valid log rmse 3.101482 5-折验证: 平均训练 log rmse 1.623464, 平均验证 log rmse 1.831805
lr=5, weight_decay=1, kind=linear, layers=None fold 1, train log rmse 0.366663, valid log rmse 0.168375 fold 2, train log rmse 0.208891, valid log rmse 0.648763 fold 3, train log rmse 0.351729, valid log rmse 0.229097 fold 4, train log rmse 0.364591, valid log rmse 0.161924 fold 5, train log rmse 0.361032, valid log rmse 0.197736 5-折验证: 平均训练 log rmse 0.330581, 平均验证 log rmse 0.281179
lr=5, weight_decay=1, kind=mlp, layers=[32] fold 1, train log rmse 0.086124, valid log rmse 0.153699 fold 2, train log rmse 0.084513, valid log rmse 0.159056 fold 3, train log rmse 0.063381, valid log rmse 0.161478 fold 4, train log rmse 0.129247, valid log rmse 0.163214 fold 5, train log rmse 0.063228, valid log rmse 0.173489 5-折验证: 平均训练 log rmse 0.085299, 平均验证 log rmse 0.162187
lr=5, weight_decay=1, kind=mlp, layers=[128] fold 1, train log rmse 0.072702, valid log rmse 0.149316 fold 2, train log rmse 0.102974, valid log rmse 0.180946 fold 3, train log rmse 0.074533, valid log rmse 0.231075 fold 4, train log rmse 0.107694, valid log rmse 0.147388 fold 5, train log rmse 0.313215, valid log rmse 0.168030 5-折验证: 平均训练 log rmse 0.134224, 平均验证 log rmse 0.175351
lr=5, weight_decay=1, kind=mlp, layers=[64, 256] fold 1, train log rmse 0.412658, valid log rmse 0.423354 fold 2, train log rmse 0.399526, valid log rmse 0.885817 fold 3, train log rmse 3.086350, valid log rmse 3.104867 fold 4, train log rmse 0.411184, valid log rmse 0.783862 fold 5, train log rmse 0.395776, valid log rmse 0.694101 5-折验证: 平均训练 log rmse 0.941099, 平均验证 log rmse 1.178400
lr=0.1, weight_decay=0, kind=linear, layers=None fold 1, train log rmse 2.410347, valid log rmse 2.423318 fold 2, train log rmse 2.410578, valid log rmse 2.421552 fold 3, train log rmse 2.408762, valid log rmse 2.424733 fold 4, train log rmse 2.418723, valid log rmse 2.391045 fold 5, train log rmse 2.411526, valid log rmse 2.415369 5-折验证: 平均训练 log rmse 2.411987, 平均验证 log rmse 2.415204
lr=0.1, weight_decay=0, kind=mlp, layers=[32] fold 1, train log rmse 0.111774, valid log rmse 0.146185 fold 2, train log rmse 0.104760, valid log rmse 0.165404 fold 3, train log rmse 0.113162, valid log rmse 0.156877 fold 4, train log rmse 0.114559, valid log rmse 0.151431 fold 5, train log rmse 0.096386, valid log rmse 0.156882 5-折验证: 平均训练 log rmse 0.108128, 平均验证 log rmse 0.155356
lr=0.1, weight_decay=0, kind=mlp, layers=[128] fold 1, train log rmse 0.069258, valid log rmse 0.138301 fold 2, train log rmse 0.056090, valid log rmse 0.155506 fold 3, train log rmse 0.077436, valid log rmse 0.148962 fold 4, train log rmse 0.070466, valid log rmse 0.141073 fold 5, train log rmse 0.076242, valid log rmse 0.162118 5-折验证: 平均训练 log rmse 0.069899, 平均验证 log rmse 0.149192
lr=0.1, weight_decay=0, kind=mlp, layers=[64, 256] fold 1, train log rmse 0.061465, valid log rmse 0.155187 fold 2, train log rmse 0.060166, valid log rmse 0.180130 fold 3, train log rmse 0.040834, valid log rmse 0.162682 fold 4, train log rmse 0.042196, valid log rmse 0.135746 fold 5, train log rmse 0.049003, valid log rmse 0.166402 5-折验证: 平均训练 log rmse 0.050733, 平均验证 log rmse 0.160029
lr=0.1, weight_decay=0.1, kind=linear, layers=None fold 1, train log rmse 2.410529, valid log rmse 2.423528 fold 2, train log rmse 2.410498, valid log rmse 2.421497 fold 3, train log rmse 2.408768, valid log rmse 2.424795 fold 4, train log rmse 2.418814, valid log rmse 2.391153 fold 5, train log rmse 2.411817, valid log rmse 2.415829 5-折验证: 平均训练 log rmse 2.412085, 平均验证 log rmse 2.415360
lr=0.1, weight_decay=0.1, kind=mlp, layers=[32] fold 1, train log rmse 0.111730, valid log rmse 0.167518 fold 2, train log rmse 0.108566, valid log rmse 0.167108 fold 3, train log rmse 0.109817, valid log rmse 0.153230 fold 4, train log rmse 0.107115, valid log rmse 0.140022 fold 5, train log rmse 0.078479, valid log rmse 0.160064 5-折验证: 平均训练 log rmse 0.103141, 平均验证 log rmse 0.157588
lr=0.1, weight_decay=0.1, kind=mlp, layers=[128] fold 1, train log rmse 0.060280, valid log rmse 0.130537 fold 2, train log rmse 0.067206, valid log rmse 0.144022 fold 3, train log rmse 0.077795, valid log rmse 0.151634 fold 4, train log rmse 0.093885, valid log rmse 0.142745 fold 5, train log rmse 0.063365, valid log rmse 0.160559 5-折验证: 平均训练 log rmse 0.072506, 平均验证 log rmse 0.145899
lr=0.1, weight_decay=0.1, kind=mlp, layers=[64, 256] fold 1, train log rmse 0.044765, valid log rmse 0.150578 fold 2, train log rmse 0.059186, valid log rmse 0.165112 fold 3, train log rmse 0.050621, valid log rmse 0.177144 fold 4, train log rmse 0.045547, valid log rmse 0.137097 fold 5, train log rmse 0.058516, valid log rmse 0.170332 5-折验证: 平均训练 log rmse 0.051727, 平均验证 log rmse 0.160053
lr=0.1, weight_decay=1, kind=linear, layers=None fold 1, train log rmse 2.411400, valid log rmse 2.424357 fold 2, train log rmse 2.411435, valid log rmse 2.422437 fold 3, train log rmse 2.410183, valid log rmse 2.426222 fold 4, train log rmse 2.419729, valid log rmse 2.392050 fold 5, train log rmse 2.412673, valid log rmse 2.416636 5-折验证: 平均训练 log rmse 2.413084, 平均验证 log rmse 2.416340
lr=0.1, weight_decay=1, kind=mlp, layers=[32] fold 1, train log rmse 0.108284, valid log rmse 0.154895 fold 2, train log rmse 0.087041, valid log rmse 0.152829 fold 3, train log rmse 0.099748, valid log rmse 0.146954 fold 4, train log rmse 0.103891, valid log rmse 0.138033 fold 5, train log rmse 0.090917, valid log rmse 0.156965 5-折验证: 平均训练 log rmse 0.097976, 平均验证 log rmse 0.149935
lr=0.1, weight_decay=1, kind=mlp, layers=[128] fold 1, train log rmse 0.058882, valid log rmse 0.130570 fold 2, train log rmse 0.060003, valid log rmse 0.144700 fold 3, train log rmse 0.071481, valid log rmse 0.147262 fold 4, train log rmse 0.070321, valid log rmse 0.128390 fold 5, train log rmse 0.065319, valid log rmse 0.154774 5-折验证: 平均训练 log rmse 0.065201, 平均验证 log rmse 0.141139
lr=0.1, weight_decay=1, kind=mlp, layers=[64, 256] fold 1, train log rmse 0.163416, valid log rmse 0.241388 fold 2, train log rmse 0.065406, valid log rmse 0.171540 fold 3, train log rmse 0.072035, valid log rmse 0.166772 fold 4, train log rmse 0.040657, valid log rmse 0.153179 fold 5, train log rmse 0.044144, valid log rmse 0.186620 5-折验证: 平均训练 log rmse 0.077132, 平均验证 log rmse 0.183900
lr=0.01, weight_decay=0, kind=linear, layers=None fold 1, train log rmse 4.694408, valid log rmse 4.708338 fold 2, train log rmse 4.694448, valid log rmse 4.704679 fold 3, train log rmse 4.692653, valid log rmse 4.708376 fold 4, train log rmse 4.702742, valid log rmse 4.675490 fold 5, train log rmse 4.695744, valid log rmse 4.699485 5-折验证: 平均训练 log rmse 4.695999, 平均验证 log rmse 4.699274
lr=0.01, weight_decay=0, kind=mlp, layers=[32] fold 1, train log rmse 0.155328, valid log rmse 0.150160 fold 2, train log rmse 0.151003, valid log rmse 0.172658 fold 3, train log rmse 0.152157, valid log rmse 0.157575 fold 4, train log rmse 0.153259, valid log rmse 0.148395 fold 5, train log rmse 0.148988, valid log rmse 0.176300 5-折验证: 平均训练 log rmse 0.152147, 平均验证 log rmse 0.161018
lr=0.01, weight_decay=0, kind=mlp, layers=[128] fold 1, train log rmse 0.134333, valid log rmse 0.143502 fold 2, train log rmse 0.129859, valid log rmse 0.146799 fold 3, train log rmse 0.129880, valid log rmse 0.143320 fold 4, train log rmse 0.134089, valid log rmse 0.135820 fold 5, train log rmse 0.127237, valid log rmse 0.166476 5-折验证: 平均训练 log rmse 0.131080, 平均验证 log rmse 0.147183
lr=0.01, weight_decay=0, kind=mlp, layers=[64, 256] fold 1, train log rmse 0.098962, valid log rmse 0.177416 fold 2, train log rmse 0.099976, valid log rmse 0.167980 fold 3, train log rmse 0.104371, valid log rmse 0.162889 fold 4, train log rmse 0.101220, valid log rmse 0.149823 fold 5, train log rmse 0.095959, valid log rmse 0.163971 5-折验证: 平均训练 log rmse 0.100097, 平均验证 log rmse 0.164416
lr=0.01, weight_decay=0.1, kind=linear, layers=None fold 1, train log rmse 4.694107, valid log rmse 4.708076 fold 2, train log rmse 4.694323, valid log rmse 4.704578 fold 3, train log rmse 4.692788, valid log rmse 4.708604 fold 4, train log rmse 4.702858, valid log rmse 4.675538 fold 5, train log rmse 4.695884, valid log rmse 4.699635 5-折验证: 平均训练 log rmse 4.695992, 平均验证 log rmse 4.699286
lr=0.01, weight_decay=0.1, kind=mlp, layers=[32] fold 1, train log rmse 0.152094, valid log rmse 0.148621 fold 2, train log rmse 0.144892, valid log rmse 0.162093 fold 3, train log rmse 0.148855, valid log rmse 0.154461 fold 4, train log rmse 0.154661, valid log rmse 0.149238 fold 5, train log rmse 0.149925, valid log rmse 0.176523 5-折验证: 平均训练 log rmse 0.150085, 平均验证 log rmse 0.158187
lr=0.01, weight_decay=0.1, kind=mlp, layers=[128] fold 1, train log rmse 0.133969, valid log rmse 0.143654 fold 2, train log rmse 0.131646, valid log rmse 0.147649 fold 3, train log rmse 0.128601, valid log rmse 0.143123 fold 4, train log rmse 0.133769, valid log rmse 0.133733 fold 5, train log rmse 0.126211, valid log rmse 0.166377 5-折验证: 平均训练 log rmse 0.130839, 平均验证 log rmse 0.146907
lr=0.01, weight_decay=0.1, kind=mlp, layers=[64, 256] fold 1, train log rmse 0.106327, valid log rmse 0.168291 fold 2, train log rmse 0.091367, valid log rmse 0.161564 fold 3, train log rmse 0.089619, valid log rmse 0.156111 fold 4, train log rmse 0.098826, valid log rmse 0.148648 fold 5, train log rmse 0.100556, valid log rmse 0.169057 5-折验证: 平均训练 log rmse 0.097339, 平均验证 log rmse 0.160734
lr=0.01, weight_decay=1, kind=linear, layers=None fold 1, train log rmse 4.694387, valid log rmse 4.708419 fold 2, train log rmse 4.694530, valid log rmse 4.704678 fold 3, train log rmse 4.693140, valid log rmse 4.708904 fold 4, train log rmse 4.703218, valid log rmse 4.675876 fold 5, train log rmse 4.695645, valid log rmse 4.699288 5-折验证: 平均训练 log rmse 4.696184, 平均验证 log rmse 4.699433
lr=0.01, weight_decay=1, kind=mlp, layers=[32] fold 1, train log rmse 0.161336, valid log rmse 0.153489 fold 2, train log rmse 0.145520, valid log rmse 0.163016 fold 3, train log rmse 0.147436, valid log rmse 0.153348 fold 4, train log rmse 0.144621, valid log rmse 0.139988 fold 5, train log rmse 0.137794, valid log rmse 0.170527 5-折验证: 平均训练 log rmse 0.147342, 平均验证 log rmse 0.156074
lr=0.01, weight_decay=1, kind=mlp, layers=[128] fold 1, train log rmse 0.128738, valid log rmse 0.139852 fold 2, train log rmse 0.125919, valid log rmse 0.145051 fold 3, train log rmse 0.124422, valid log rmse 0.139591 fold 4, train log rmse 0.135794, valid log rmse 0.137643 fold 5, train log rmse 0.120521, valid log rmse 0.162298 5-折验证: 平均训练 log rmse 0.127079, 平均验证 log rmse 0.144887
lr=0.01, weight_decay=1, kind=mlp, layers=[64, 256] fold 1, train log rmse 0.093213, valid log rmse 0.178106 fold 2, train log rmse 0.092631, valid log rmse 0.161349 fold 3, train log rmse 0.092881, valid log rmse 0.158807 fold 4, train log rmse 0.099234, valid log rmse 0.145731 fold 5, train log rmse 0.098145, valid log rmse 0.167022 5-折验证: 平均训练 log rmse 0.095221, 平均验证 log rmse 0.162203
已保存输出
      lr  weight_decay    kind     layers  train_log_rmse  valid_log_rmse
0   5.00           0.0  linear       None        0.145831        0.155586
1   5.00           0.0     mlp       [32]        0.065800        0.173640
2   5.00           0.0     mlp      [128]        0.065720        0.156077
3   5.00           0.0     mlp  [64, 256]        1.538820        1.647424
4   5.00           0.1  linear       None        0.156056        0.169301
5   5.00           0.1     mlp       [32]        0.064620        0.153185
6   5.00           0.1     mlp      [128]        0.108799        0.280521
7   5.00           0.1     mlp  [64, 256]        1.623464        1.831805
8   5.00           1.0  linear       None        0.330581        0.281179
9   5.00           1.0     mlp       [32]        0.085299        0.162187
10  5.00           1.0     mlp      [128]        0.134224        0.175351
11  5.00           1.0     mlp  [64, 256]        0.941099        1.178400
12  0.10           0.0  linear       None        2.411987        2.415204
13  0.10           0.0     mlp       [32]        0.108128        0.155356
14  0.10           0.0     mlp      [128]        0.069899        0.149192
15  0.10           0.0     mlp  [64, 256]        0.050733        0.160029
16  0.10           0.1  linear       None        2.412085        2.415360
17  0.10           0.1     mlp       [32]        0.103141        0.157588
18  0.10           0.1     mlp      [128]        0.072506        0.145899
19  0.10           0.1     mlp  [64, 256]        0.051727        0.160053
20  0.10           1.0  linear       None        2.413084        2.416340
21  0.10           1.0     mlp       [32]        0.097976        0.149935
22  0.10           1.0     mlp      [128]        0.065201        0.141139
23  0.10           1.0     mlp  [64, 256]        0.077132        0.183900
24  0.01           0.0  linear       None        4.695999        4.699274
25  0.01           0.0     mlp       [32]        0.152147        0.161018
26  0.01           0.0     mlp      [128]        0.131080        0.147183
27  0.01           0.0     mlp  [64, 256]        0.100097        0.164416
28  0.01           0.1  linear       None        4.695992        4.699286
29  0.01           0.1     mlp       [32]        0.150085        0.158187
30  0.01           0.1     mlp      [128]        0.130839        0.146907
31  0.01           0.1     mlp  [64, 256]        0.097339        0.160734
32  0.01           1.0  linear       None        4.696184        4.699433
33  0.01           1.0     mlp       [32]        0.147342        0.156074
34  0.01           1.0     mlp      [128]        0.127079        0.144887
35  0.01           1.0     mlp  [64, 256]        0.095221        0.162203
最后完整训练一次,提交预测结果
def train_and_pred(train_features, test_features,
                   train_labels, test_data,
                   num_epochs, batch_size,
                   lr, weight_decay,
                   **kwargs):
    net = get_net(**kwargs)
    train_ls, _ = train(net, train_features, train_labels, None, None,
                        num_epochs, batch_size, lr, weight_decay)
    print(f'训练 log rmse {float(train_ls[-1]):f}')
    # 预测
    preds = net(test_features).detach().numpy()
    # 将预测结果写入文件
    test_data['SalePrice'] = pd.Series(preds.reshape(1, -1)[0])
    submission = pd.concat([test_data['Id'], test_data['SalePrice']], axis=1) # 只保留 id 和预测价格
    submission.to_csv('./results/kaggle_house_price.csv', index=False)

final_lr = 0.01
final_weight_decay = 1
final_kind = 'mlp'
final_layers = [128]
train_and_pred(train_features, test_features,
               train_labels, test_data,
               num_epochs, batch_size,
               final_lr, final_weight_decay,
               kind=final_kind, layers=final_layers)
已保存输出
训练 log rmse 0.120354