机器学习 / A LEAF IN THE GARDEN
VGG
机器学习 · 动手深度学习。来自 Daily Learning 的学习笔记。
简介
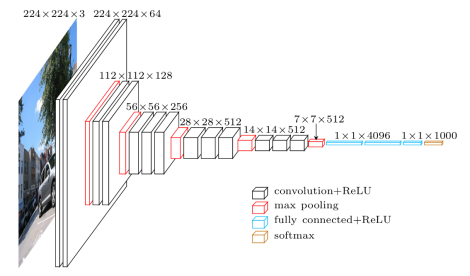
由牛津大学视觉几何组(Visual Geometry Group)提出。主要特点是使用小卷积核(3x3)堆叠成块,使用块构建深度网络。
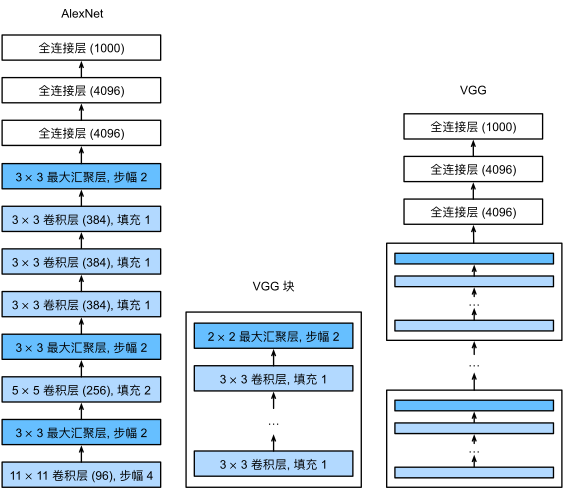
VGG 块
一个 VGG 块有若干个卷积层和一个池化层收尾。
- n 个 3x3 卷积核(步幅 1,填充 1)
- 2x2 最大池化(步幅 2)
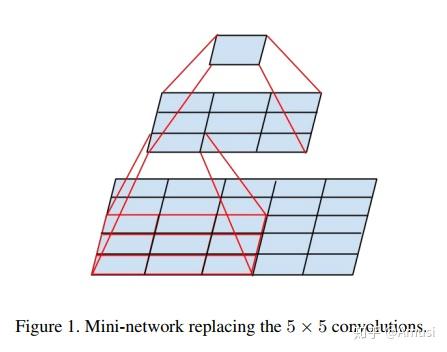
多个 3x3 卷积核堆叠可以扩大感受野,并且比大卷积核的非线性拟合能力更强。
VGG 用块堆叠的方式改进 AlexNet 一些略显随意的设计
实现
代码 3 · In [1]
import torch
from torch import nn
import torchinfo
import util
已保存输出
/root/autodl-tmp/envs/daily_learning/lib/python3.11/site-packages/requests/__init__.py:92: RequestsDependencyWarning: Unable to find acceptable character detection dependency (chardet or charset_normalizer).
  warnings.warn(
VGG 块
代码 5 · In [2]
def vgg_block(num_convs: int, in_channels: int, out_channels: int):
    """VGG 块
    :param num_convs: 卷积层数
    :param in_channels: 输入通道数
    :param out_channels: 输出通道数
    """
    layers = []
    # 逐层堆叠卷积层和 ReLU
    for _ in range(num_convs):
        layers.append(nn.Conv2d(in_channels, out_channels, kernel_size=3, padding=1))
        layers.append(nn.ReLU())
        # 第一次循环后,输入通道数变为输出通道数
        in_channels = out_channels
    # 池化层收尾
    layers.append(nn.MaxPool2d(kernel_size=2, stride=2))
    return nn.Sequential(*layers)
代码 6 · In [3]
def vgg(conv_arch: list[tuple[int, int]], in_channels: int=1) -> nn.Sequential:
    """VGG 网络
    :param conv_arch: 卷积层架构,列表中每个元素是一个元组 (num_convs, out_channels)
    :param in_channels: 输入通道数
    :return: VGG 网络
    """
    # 固定 5 块,正好把 224x224 的图像缩小到 7x7
    assert len(conv_arch) == 5, "VGG 网络必须有 5 个卷积块"
    conv_blks = [] # 存储 VGG 块
    for (num_convs, out_channels) in conv_arch:
        conv_blks.append(vgg_block(num_convs, in_channels, out_channels))
        # 下一层的输入通道数 是 当前的输出通道数
        in_channels = out_channels
    return nn.Sequential(
        *conv_blks, # 堆叠所有 VGG 块
        nn.Flatten(), # 7x7 的特征图展平为向量
        # 三个全连接层
        nn.Linear(out_channels * 7 * 7, 4096), nn.ReLU(), nn.Dropout(0.5),
        nn.Linear(4096, 4096), nn.ReLU(), nn.Dropout(0.5),
        nn.Linear(4096, 10)
    )
VGG-11 的架构,每一块高宽减半,通道数翻倍
代码 8 · In [4]
conv_arch = [(1, 64),
             (1, 128),
             (2, 256),
             (2, 512),
             (2, 512)]
net = vgg(conv_arch, in_channels=1)
torchinfo.summary(net, input_size=(1, 1, 224, 224), col_names=["input_size", "output_size", "num_params"])
已保存输出
===================================================================================================================
Layer (type:depth-idx)                   Input Shape               Output Shape              Param #
===================================================================================================================
Sequential                               [1, 1, 224, 224]          [1, 10]                   --
├─Sequential: 1-1                        [1, 1, 224, 224]          [1, 64, 112, 112]         --
│    └─Conv2d: 2-1                       [1, 1, 224, 224]          [1, 64, 224, 224]         640
│    └─ReLU: 2-2                         [1, 64, 224, 224]         [1, 64, 224, 224]         --
│    └─MaxPool2d: 2-3                    [1, 64, 224, 224]         [1, 64, 112, 112]         --
├─Sequential: 1-2                        [1, 64, 112, 112]         [1, 128, 56, 56]          --
│    └─Conv2d: 2-4                       [1, 64, 112, 112]         [1, 128, 112, 112]        73,856
│    └─ReLU: 2-5                         [1, 128, 112, 112]        [1, 128, 112, 112]        --
│    └─MaxPool2d: 2-6                    [1, 128, 112, 112]        [1, 128, 56, 56]          --
├─Sequential: 1-3                        [1, 128, 56, 56]          [1, 256, 28, 28]          --
│    └─Conv2d: 2-7                       [1, 128, 56, 56]          [1, 256, 56, 56]          295,168
│    └─ReLU: 2-8                         [1, 256, 56, 56]          [1, 256, 56, 56]          --
│    └─Conv2d: 2-9                       [1, 256, 56, 56]          [1, 256, 56, 56]          590,080
│    └─ReLU: 2-10                        [1, 256, 56, 56]          [1, 256, 56, 56]          --
│    └─MaxPool2d: 2-11                   [1, 256, 56, 56]          [1, 256, 28, 28]          --
├─Sequential: 1-4                        [1, 256, 28, 28]          [1, 512, 14, 14]          --
│    └─Conv2d: 2-12                      [1, 256, 28, 28]          [1, 512, 28, 28]          1,180,160
│    └─ReLU: 2-13                        [1, 512, 28, 28]          [1, 512, 28, 28]          --
│    └─Conv2d: 2-14                      [1, 512, 28, 28]          [1, 512, 28, 28]          2,359,808
│    └─ReLU: 2-15                        [1, 512, 28, 28]          [1, 512, 28, 28]          --
│    └─MaxPool2d: 2-16                   [1, 512, 28, 28]          [1, 512, 14, 14]          --
├─Sequential: 1-5                        [1, 512, 14, 14]          [1, 512, 7, 7]            --
│    └─Conv2d: 2-17                      [1, 512, 14, 14]          [1, 512, 14, 14]          2,359,808
│    └─ReLU: 2-18                        [1, 512, 14, 14]          [1, 512, 14, 14]          --
│    └─Conv2d: 2-19                      [1, 512, 14, 14]          [1, 512, 14, 14]          2,359,808
│    └─ReLU: 2-20                        [1, 512, 14, 14]          [1, 512, 14, 14]          --
│    └─MaxPool2d: 2-21                   [1, 512, 14, 14]          [1, 512, 7, 7]            --
├─Flatten: 1-6                           [1, 512, 7, 7]            [1, 25088]                --
├─Linear: 1-7                            [1, 25088]                [1, 4096]                 102,764,544
├─ReLU: 1-8                              [1, 4096]                 [1, 4096]                 --
├─Dropout: 1-9                           [1, 4096]                 [1, 4096]                 --
├─Linear: 1-10                           [1, 4096]                 [1, 4096]                 16,781,312
├─ReLU: 1-11                             [1, 4096]                 [1, 4096]                 --
├─Dropout: 1-12                          [1, 4096]                 [1, 4096]                 --
├─Linear: 1-13                           [1, 4096]                 [1, 10]                   40,970
===================================================================================================================
Total params: 128,806,154
Trainable params: 128,806,154
Non-trainable params: 0
Total mult-adds (Units.GIGABYTES): 7.55
===================================================================================================================
Input size (MB): 0.20
Forward/backward pass size (MB): 59.47
Params size (MB): 515.22
Estimated Total Size (MB): 574.90
===================================================================================================================
太大了,减少一些通道数来训练
代码 10 · In [9]
ratio = 4
small_arch = [(convs, channels // ratio) for (convs, channels) in conv_arch]
net = vgg(small_arch, in_channels=1)
代码 11 · In [11]
lr = 0.09
num_epochs = 10
batch_size = 128
train_iter, test_iter = util.data.load_data_fashion_mnist(batch_size=batch_size, resize=224)
util.train.train_ch6(net, train_iter, test_iter, num_epochs, lr, device=util.try_gpu())
已保存输出
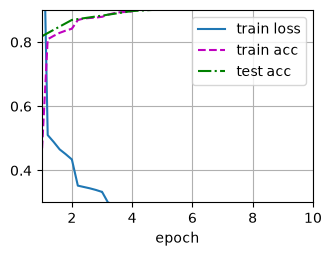
loss 0.167, train acc 0.938, test acc 0.920
6058.3 examples/sec on cuda:0
代码 12 · In [13]
torch.save(net.state_dict(), "./models/VGG.pth")