机器学习 / A LEAF IN THE GARDEN
ResNet
机器学习 · 动手深度学习。来自 Daily Learning 的学习笔记。
残差连接
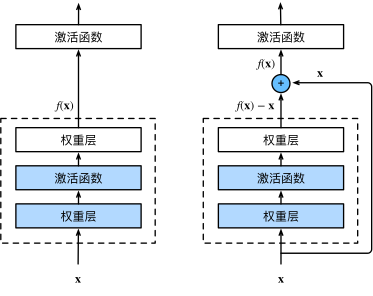
在函数中加入一个快速通道,使输入可以直接传递到输出。
梯度
此时计算梯度
- 梯度中有一个恒等项1,使得梯度不会消失。
- 每一层的梯度都包含了上一层的梯度,使得梯度可以直接传递到最前面。
残差层
将卷积层、线性层等作为函数 ,加入残差连接,形成残差层 。
此时 的目标是学习一个残差函数,即目标映射与输入的差值。
因此模型有了“摆烂”的能力,即一层如果学不好,可以直接原样输出,保证梯度传递。
ResNet 残差块
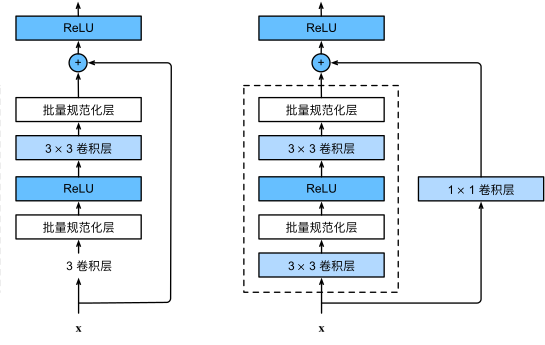
VGG 块的基础上加入 batch norm 和残差连接,形成 ResNet 残差块。
也可以在残差连接处额外加一个 1x1 卷积层,调整通道数。
ResNet 网络结构
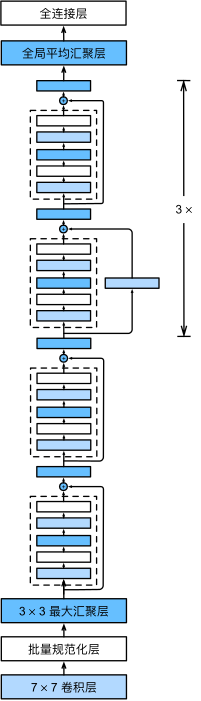
类似 VGG 和 GoogLeNet 的总体架构,但换成了残差块。
- 高宽减半 ResNet 块(步幅2)
- 后接多个高宽不变 ResNet 块
实现
代码 6 · In [1]
import torch
from torch import nn
import torchinfo
import util
已保存输出
/root/autodl-tmp/envs/daily_learning/lib/python3.11/site-packages/requests/__init__.py:92: RequestsDependencyWarning: Unable to find acceptable character detection dependency (chardet or charset_normalizer).
  warnings.warn(
残差块
代码 8 · In [3]
class Residual(nn.Module):
    def __init__(self, input_channels, num_channels, use_1x1conv=False, strides=1):
        """
        @param input_channels: 输入通道数
        @param num_channels: 输出通道数
        @param use_1x1conv: 是否使用 1x1 卷积(调整通道)
        @param strides: 第一个卷积层步幅
        """
        assert (input_channels == num_channels) or use_1x1conv, "输入输出通道数不一致,必须使用 1x1 卷积调整通道数"
        super().__init__()
        # 第一个卷积层(可调步幅),在这里把通道变成输出通道数
        self.conv1 = nn.Conv2d(input_channels, num_channels, kernel_size=3, padding=1, stride=strides)
        # 第二个卷积层不改变高宽和通道
        self.conv2 = nn.Conv2d(num_channels, num_channels, kernel_size=3, padding=1)
        if use_1x1conv:
            # 如果需要调整通道数(输入输出通道不一样),则使用 1x1 卷积层
            self.conv3 = nn.Conv2d(input_channels, num_channels, kernel_size=1, stride=strides)
        else:
            self.conv3 = None
        self.bn1 = nn.BatchNorm2d(num_channels)
        self.bn2 = nn.BatchNorm2d(num_channels)
        self.relu = nn.ReLU(inplace=True) # inplace=True 表示直接在原来的内存上进行操作,节省内存

    def forward(self, X):
        # 得到 g(x)
        Y = self.relu(self.bn1(self.conv1(X)))
        Y = self.bn2(self.conv2(Y))
        # 是否调整通道数
        if self.conv3:
            X = self.conv3(X)
        # 残差连接
        Y += X
        return self.relu(Y)
输入输出形状不变
增加通道,减半高宽(常见操作)
代码 11 · In [5]
blk = Residual(3, 6, use_1x1conv=True, strides=2)
X = torch.rand(4, 3, 6, 6)
blk(X).shape # 4, 6, 3, 3
已保存输出
torch.Size([4, 6, 3, 3])
ResNet 网络
代码 13 · In [10]
b1 = nn.Sequential(
    nn.Conv2d(1, 64, kernel_size=7, stride=2, padding=3),
    nn.BatchNorm2d(64),
    nn.ReLU(),
    nn.MaxPool2d(kernel_size=3, stride=2, padding=1)
)

def resnet_block(input_channels, num_channels, num_residuals, first_block=False)->nn.Sequential:
    """
    @param input_channels: 输入通道数
    @param num_channels: 输出通道数
    @param num_residuals: 残差块的数量
    @param first_block: 是否是第一个残差块(第一个残差块不需要调整通道数和高宽)
    """
    blk = []
    for i in range(num_residuals):
        if i == 0 and not first_block:
            # 第一个残差块需要调整通道数和高宽
            blk.append(Residual(input_channels, num_channels, use_1x1conv=True, strides=2))
        else:
            blk.append(Residual(num_channels, num_channels))
    return nn.Sequential(*blk)

b2 = resnet_block(64, 64, 2, first_block=True)
b3 = resnet_block(64, 128, 2)
b4 = resnet_block(128, 256, 2)
b5 = resnet_block(256, 512, 2)

net = nn.Sequential(
    b1, b2, b3, b4, b5,
    nn.AdaptiveAvgPool2d((1, 1)), # 全局平均池化
    nn.Flatten(),
    nn.Linear(512, 10) # 输出 10 类
)
代码 14 · In [11]
torchinfo.summary(net,
                  input_size=(1, 1, 224, 224),
                  col_names=["input_size", "output_size", "num_params", "mult_adds"],
                  col_width=20,
                  depth=2)
已保存输出
========================================================================================================================
Layer (type:depth-idx)                   Input Shape          Output Shape         Param #              Mult-Adds
========================================================================================================================
Sequential                               [1, 1, 224, 224]     [1, 10]              --                   --
├─Sequential: 1-1                        [1, 1, 224, 224]     [1, 64, 56, 56]      --                   --
│    └─Conv2d: 2-1                       [1, 1, 224, 224]     [1, 64, 112, 112]    3,200                40,140,800
│    └─BatchNorm2d: 2-2                  [1, 64, 112, 112]    [1, 64, 112, 112]    128                  128
│    └─ReLU: 2-3                         [1, 64, 112, 112]    [1, 64, 112, 112]    --                   --
│    └─MaxPool2d: 2-4                    [1, 64, 112, 112]    [1, 64, 56, 56]      --                   --
├─Sequential: 1-2                        [1, 64, 56, 56]      [1, 64, 56, 56]      --                   --
│    └─Residual: 2-5                     [1, 64, 56, 56]      [1, 64, 56, 56]      74,112               231,612,672
│    └─Residual: 2-6                     [1, 64, 56, 56]      [1, 64, 56, 56]      74,112               231,612,672
├─Sequential: 1-3                        [1, 64, 56, 56]      [1, 128, 28, 28]     --                   --
│    └─Residual: 2-7                     [1, 64, 56, 56]      [1, 128, 28, 28]     230,272              180,132,352
│    └─Residual: 2-8                     [1, 128, 28, 28]     [1, 128, 28, 28]     295,680              231,412,224
├─Sequential: 1-4                        [1, 128, 28, 28]     [1, 256, 14, 14]     --                   --
│    └─Residual: 2-9                     [1, 128, 28, 28]     [1, 256, 14, 14]     919,296              179,982,336
│    └─Residual: 2-10                    [1, 256, 14, 14]     [1, 256, 14, 14]     1,181,184            231,312,384
├─Sequential: 1-5                        [1, 256, 14, 14]     [1, 512, 7, 7]       --                   --
│    └─Residual: 2-11                    [1, 256, 14, 14]     [1, 512, 7, 7]       3,673,600            179,908,096
│    └─Residual: 2-12                    [1, 512, 7, 7]       [1, 512, 7, 7]       4,721,664            231,263,232
├─AdaptiveAvgPool2d: 1-6                 [1, 512, 7, 7]       [1, 512, 1, 1]       --                   --
├─Flatten: 1-7                           [1, 512, 1, 1]       [1, 512]             --                   --
├─Linear: 1-8                            [1, 512]             [1, 10]              5,130                5,130
========================================================================================================================
Total params: 11,178,378
Trainable params: 11,178,378
Non-trainable params: 0
Total mult-adds (Units.GIGABYTES): 1.74
========================================================================================================================
Input size (MB): 0.20
Forward/backward pass size (MB): 38.33
Params size (MB): 44.71
Estimated Total Size (MB): 83.25
========================================================================================================================
训练
代码 16 · In [12]
lr = 0.05
num_epochs = 10
batch_size = 128
train_iter, test_iter = util.data.load_data_fashion_mnist(batch_size=batch_size, resize=224)
util.train.train_ch6(net, train_iter, test_iter, num_epochs, lr, util.try_gpu(), ylim=(0.3, 1))
已保存输出
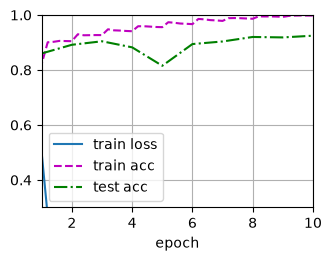
loss 0.010, train acc 0.998, test acc 0.925
3048.0 examples/sec on cuda:0
代码 17 · In [13]
torch.save(net.state_dict(), "./models/ResNet.pth")